DeepSeek 崩上热搜:当 AI 暂时不可用,你的工作还能继续吗?
你好,我是真成。
今天上午,DeepSeek 出现服务异常,“DeepSeek崩了”相关话题登上微博热搜。
根据媒体报道,有用户打开网页或 App,发送消息后收到“服务器暂时不可用”的提示。原本准备让 AI 帮忙改文章、整理材料、辅助写代码,结果卡在了等待回复这一步。来源:央视财经报道(凤凰网转载):https://finance.ifeng.com/c/8xEr6INc5QN、新黄河报道:https://www.sohu.com/a/1087978304_121347613。
今天我们来看看发生了什么,再聊聊这次故障给日常使用和运维工作带来的提醒。
1)发生了什么,目前修好了吗?
先把时间线捋清楚。下面时间均为北京时间。
-
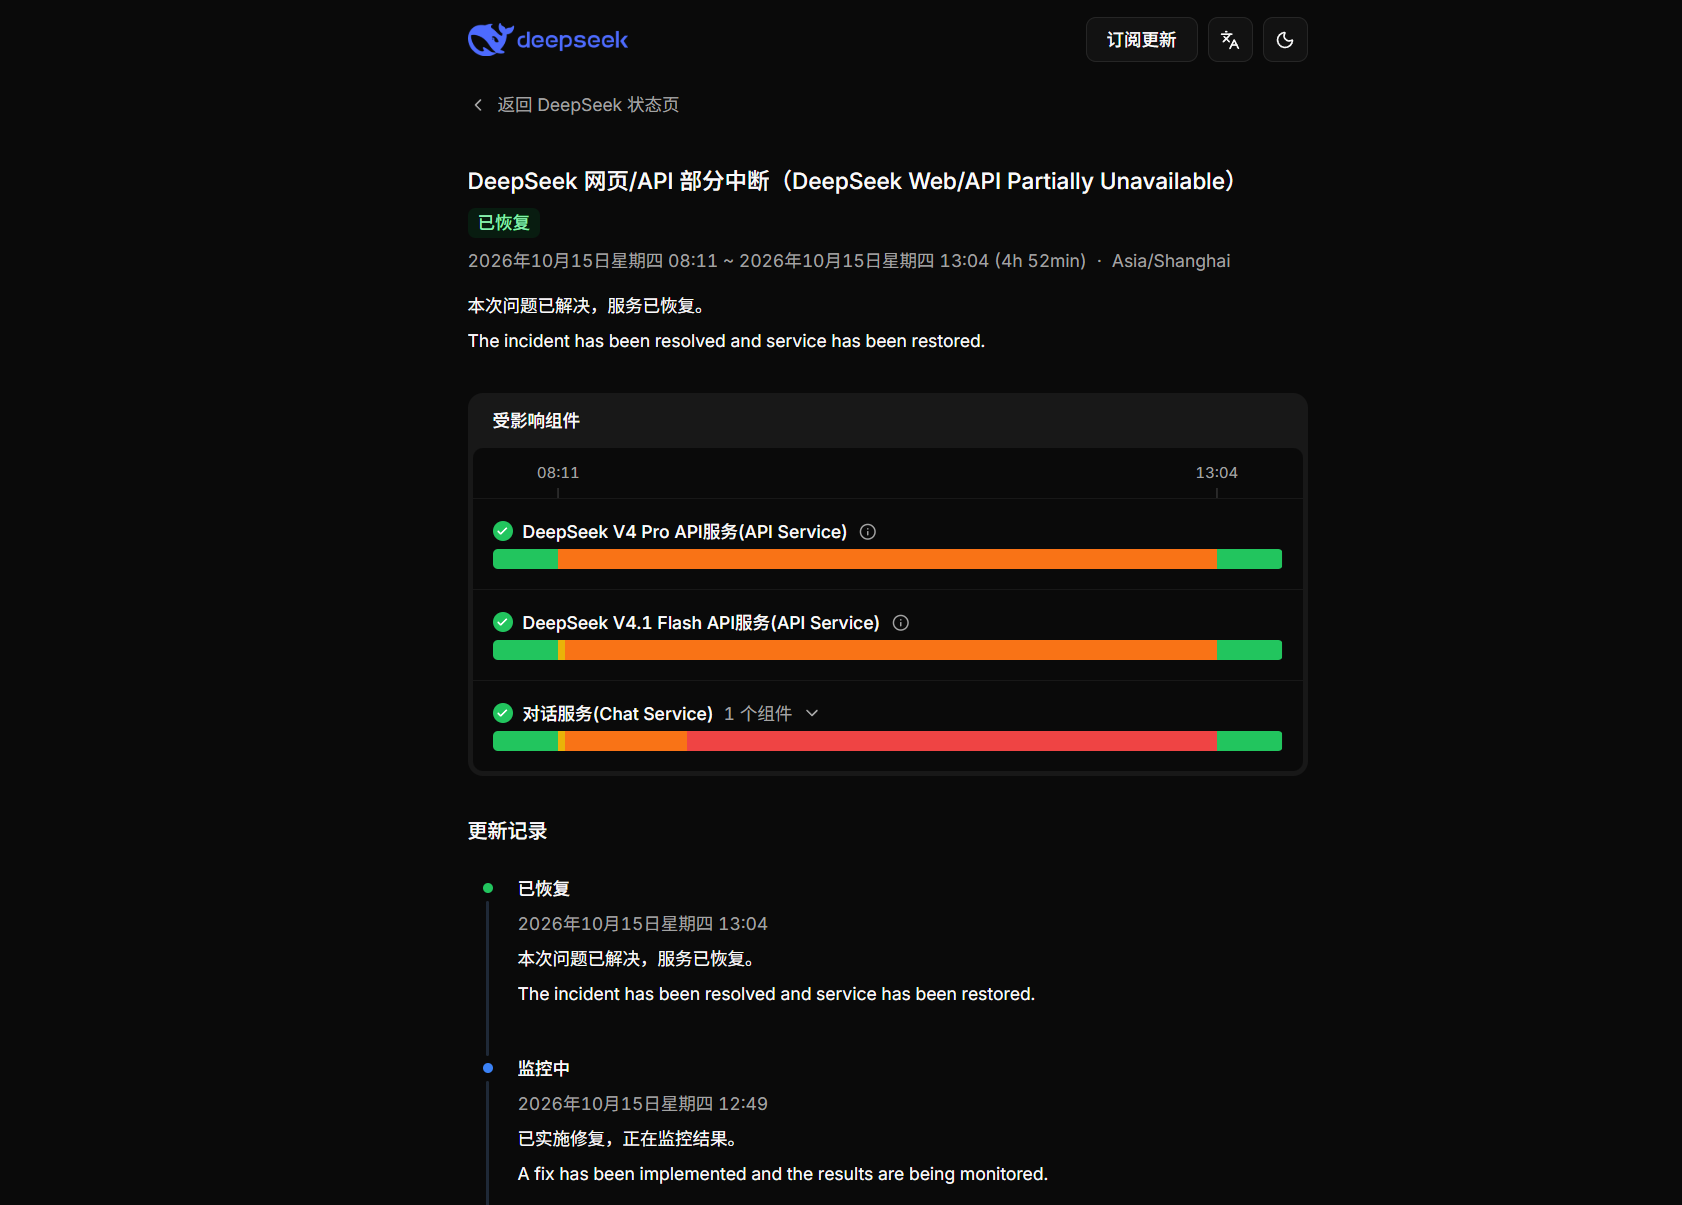
08:11:官方开始记录此次异常,进入问题排查阶段。 -
09:06:官方更新为已定位原因,开始实施修复;09:08 再次更新了相同处理状态。 -
12:49:官方更新为已实施修复,正在监控结果。 -
13:04:官方更新为“本次问题已解决,服务已恢复”。
此次事件在官方状态页被标记为“DeepSeek 网页/API 部分中断”。页面列出的受影响范围包括对话服务、DeepSeek V4 Pro API 服务和 DeepSeek V4.1 Flash API 服务。来源:DeepSeek 官方故障记录:https://status.deepseek.com/incidents/7116348214287。
也就是说,影响涉及大家直接使用的聊天入口,也涉及开发者调用的接口。
官方已于 2026 年 10 月 15 日 13:04 宣布:本次问题已解决,服务已恢复。 从 08:11 首次记录异常到 13:04 宣布恢复,相隔约 4 小时 53 分钟;这是官方事件记录的时间跨度,不能直接当作所有用户完全无法使用的时长。
2)为什么会故障?现在还不能下结论
本次事件已宣布恢复。就本文所依据的公开记录而言,官方说明了处理进度,尚未披露具体技术根因。来源:DeepSeek 官方故障记录:https://status.deepseek.com/incidents/7116348214287。
这里需要注意:“已定位原因”,意味着处理团队已经有了判断,不代表原因已经向公众公开。
只看到“服务器暂时不可用”,无法判断究竟是哪一层出了问题。容量、发布变更、网络、存储、依赖服务,都可以是排查方向;要确认这次事故的原因,还得有对应证据。
做运维的朋友应该很熟悉这个区别:用户看到的是一个报错,后台要查的可能是一整条调用链。
所以,现在就把事故归结为“算力不够”“被攻击”或者“上线新模型”,都缺少依据。可以讨论可能性,但写进事件经过时,必须把猜测和事实分开。
3)我的看法:AI 已经进入工作流程,稳定性也得跟上
一个聊天工具打不开,为什么会引起这么多关注?
我的理解是,越来越多人的工作流程里,已经有了“先问一下 AI”这一步。写材料前让它列提纲,排查问题时让它梳理思路,写完代码后让它帮忙检查。
用顺手之后,服务一停,原来的工作节奏也跟着被打断。
这也意味着,大家对 AI 产品的要求会越来越具体:回答是否准确、响应够不够快、需要用的时候能不能用,都会影响使用体验。
模型能力决定大家愿不愿意尝试,服务稳定性影响大家敢不敢把重要工作交给它。
对服务提供方来说,故障期间持续说明影响范围和处理进度,能帮助用户决定继续等待,还是先调整工作安排。如果后续能公开复盘,解释原因和改进措施,也更有助于用户建立合理预期。
4)普通用户和做应用的人,都可以留一点余量
对普通用户,我觉得有三件事值得养成习惯。
第一,重要内容及时保存。 长文提纲、已经确认的方案、反复修改过的提示词,最好在自己的文档里保留一份。关键材料有自己的存档,换工具时也方便继续。
第二,给紧急任务留一个替代办法。 临近交付时,可以先人工完成框架,或者换用自己已经熟悉、且适合当前材料处理要求的工具。临时切换也需要重新检查输出,别把“有回复”当成“任务完成”。
第三,先确认服务状态,再决定怎么排查。 遇到异常,可以查看官方状态页,结合自己的网络和报错判断。确认平台有故障后,频繁重装 App、反复登录,往往只会耽误手头的事。
官网指路:DeepSeek 服务状态页:https://status.deepseek.com/
如果你正在开发调用大模型的应用,这次事件还值得拿来检查几个问题:请求失败后,用户输入是否还在?页面会不会一直转圈?系统有没有明确的超时和重试上限?依赖不可用时,能不能先保存任务,让用户稍后继续?
这些设计未必复杂,但会直接影响用户在故障发生时,究竟是暂时等一等,还是连刚刚做的工作也一起丢了。
至于备用模型,也需要提前验证任务效果、数据处理要求和成本。把接口换过去,只完成了切换的一部分。
写在最后
这次服务已经恢复。我更关心后续是否会有清楚的事故复盘,以及类似问题能怎样减少。
对我们自己来说,也可以顺手检查一下:如果常用的 AI 暂时不可用,今天最重要的工作,还能不能继续往前走?
AI 可以继续用,自己的资料、判断和工作方法,也要一直攥在手里。
END
非特殊说明,本博所有文章均为博主原创。
如若转载,请注明出处:https://www.qiuyl.com/itzixun/648

Abutogel: <a href=" https://abutowin.icu/# ">S...